
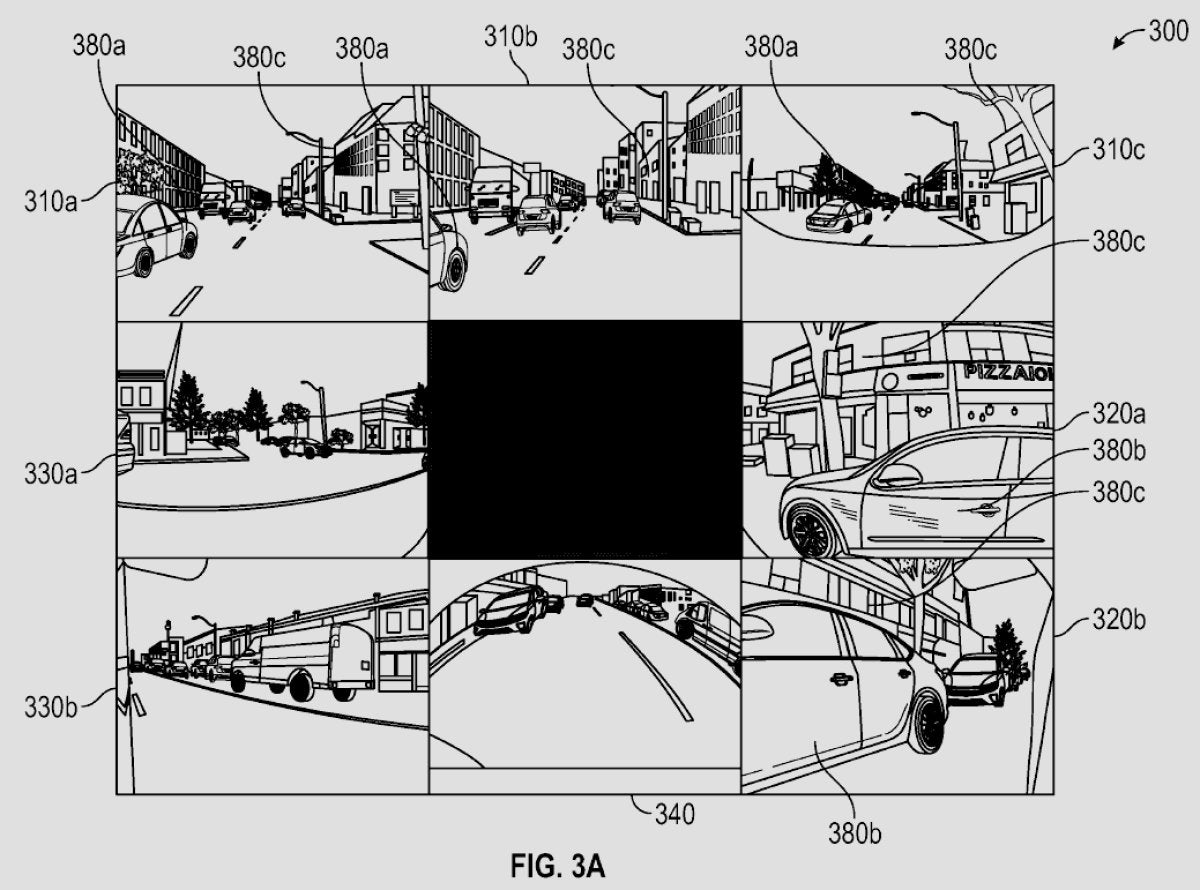
Les parties précédentes de cette série ont abordé les fondements de la pile d'aide à la conduite de l'entreprise et la manière dont elle interprète les scènes. Ce volet se concentre sur la façon dont le système convertit des images de caméra plates en la représentation tridimensionnelle qu'il utilise pour conduire, en s'appuyant sur deux dépôts de brevets : la détermination de l'occupation basée sur la vision et la détermination de la surface basée sur la vision. Ensemble, ils décrivent comment la pile perçoit tout, des véhicules à la texture de la route, en utilisant uniquement la vision.
Comment fonctionne le FSD, Partie 1
Comment fonctionne le FSD, Partie 2
Comment fonctionne le FSD, Partie 3 (cet article)
Le traducteur IA universel de Tesla
Comment Tesla optimise le FSD
Comment Tesla va étiqueter les données avec l'IA

Créer un monde 3D à partir d'images 2D
Le problème central pour un système d'aide à la conduite basé sur la vision est de reconstruire une scène tridimensionnelle à partir d'entrées de caméra bidimensionnelles. Contrairement aux approches qui utilisent le LiDAR pour mesurer la distance directement, une méthode basée uniquement sur la vision doit déduire la profondeur, la forme, le mouvement et le contexte à partir des pixels, de l'éclairage et de la manière dont les objets se déplacent à travers plusieurs perspectives de caméra. La combinaison de ces indices produit l'environnement 3D dans lequel le planificateur opère.
Partie 1 : Détermination de l'occupation basée sur la vision

Le brevet intitulé « Techniques de modélisation par intelligence artificielle pour la détermination de l'occupation basée sur la vision » décrit comment le système identifie les objets autour du véhicule et l'espace qu'ils occupent. Les itérations précédentes utilisaient des boîtes englobantes 2D ; les versions plus récentes visent une compréhension véritablement volumétrique.
Pipeline FSD : des pixels aux objets

Le brevet décrit un pipeline d'IA à plusieurs étapes :
Entrée d'image : Les images brutes des caméras provenant de multiples points de vue autour de la voiture sont ingérées à un moment donné.
Featurisation des images : Des réseaux neuronaux spécialisés appelés « Featurizers » extraient des caractéristiques visuelles utiles à partir des pixels, telles que des motifs, des textures et des contours.
Transformation spatiale : Un réseau de type « transformer » avec un mécanisme d'attention spatiale projette les caractéristiques de chaque caméra dans un cadre 3D commun et les fusionne. En interne, cela forme l'espace vectoriel dans lequel le planificateur de trajectoire opère.
Alignement temporel : Le système fusionne les caractéristiques 3D à travers des moments consécutifs afin qu'elles deviennent spatiotemporelles, capturant non seulement un instant, mais le mouvement dans le temps.
Déconvolution : La représentation fusionnée est déconvoluée pour produire des prédictions par voxel à travers une grille 3D.
Un voxel est l'analogue 3D d'un pixel : un petit cube représentant un point dans l'espace. L'environnement autour de la voiture est discrétisé en une grille dense de voxels.
À partir des sorties déconvoluées, le réseau prédit des signaux clés tels que l'occupation (libre ou occupé) et, lorsqu'il est occupé, un vecteur de vitesse. En agrégeant les données à travers les voxels, le système forme une image détaillée de l'espace proche et de ce qui le remplit, qu'il s'agisse d'une structure statique ou d'un usager de la route en mouvement.

La sortie
Les résultats sont compilés dans une carte d'occupation que le planificateur en aval peut interroger pour décider des actions à entreprendre — en vérifiant si des régions spécifiques sont libres, si un objet dans un voxel est en mouvement, ce que cela pourrait être, et si cela a de l'importance pour la conduite. Le planificateur utilise ce modèle 3D mis à jour en permanence pour prendre des décisions d'un instant à l'autre, un peu comme dans un monde de type « jeu vidéo » en direct où les entités ont une position, un mouvement et un type.
Partie 2 : Détermination de la surface basée sur la vision
Détecter les objets n'est qu'une partie du problème ; comprendre la surface circulable et le terrain environnant est tout aussi important. Le brevet WO2024237939A2, « Techniques de modélisation par intelligence artificielle pour la détermination de la surface basée sur la vision », répond à ce besoin.
Compréhension de la surface
Le système doit déduire bien plus que « il y a une route ». Il estime la géométrie de la route (plate, en montée, inclinée), le matériau de surface (asphalte, terre, gravier), les bordures, le marquage au sol, les dos-d'âne, les nids-de-poule et si une région est réellement navigable. Le brevet explique comment atteindre ce niveau de détail à partir des seules caméras, réduisant ainsi la dépendance aux cartes haute définition préexistantes.
Pour ceux qui suivent de près, le système tente effectivement d'identifier les nids-de-poule ; la question de savoir si le planificateur utilise actuellement ce signal peut varier. En 2020, Elon Musk a confirmé que c'était le cas.
Oui ! Nous étiquetons les bosses et les nids-de-poule, afin que la voiture puisse ralentir ou les contourner lorsque cela est sûr.
— Elon Musk (@elonmusk) 14 août 2020
L'entreprise a également discuté de l'ajustement de la suspension pneumatique et adaptative en fonction d'une carte de la rugosité de la route. De telles cartes pourraient combiner les sorties de la détermination de la surface basée sur la vision avec les signaux provenant des nouveaux capteurs intelligents de bande de roulement des pneus, actuellement installés sur certains véhicules phares.
Prédiction des attributs de surface à partir de la vision
Ce composant analyse les images pour prédire les attributs de surface plutôt que l'occupation des objets. Les sorties incluent l'élévation, la navigabilité et la sécurité pour la conduite, le matériau de surface et des caractéristiques telles que les lignes de voie, les marquages, les bordures, les dos-d'âne, les nids-de-poule, les crêtes de colline et les virages inclinés ou plats.
Construction du maillage de surface 3D
Ces prédictions sont assemblées dans un maillage 3D des environs dérivé de l'imagerie 2D. Le maillage est un ensemble de points avec des coordonnées X, Y et Z, chacun marqué avec les attributs déduits, formant une partie du monde 3D global utilisé par le système.

Formation à la reconnaissance de surface
La formation exploite des sources de profondeur haute fidélité telles que le LIDAR lors des tests et de la génération de données, ainsi que la photogrammétrie. Celles-ci sont alignées avec les images de caméra capturées par de vrais véhicules pour apprendre les distances et les propriétés de surface.
Occupation + Surfaces = Modèle de monde unifié
Les systèmes d'occupation et de surface sont conçus pour fonctionner ensemble. Par exemple, si l'occupation détecte un cône de signalisation alors que le système de surface reconnaît une colline abrupte devant, le modèle peut placer le cône précisément sur la pente de la colline au sein du monde 3D. Séparer la détection d'objets de la compréhension de la surface améliore la robustesse dans les environnements présentant une élévation variable et augmente la plage verticale dans laquelle les objets peuvent être localisés de manière fiable.
En conséquence, la pile ne perçoit pas seulement des objets isolés et un plan au sol plat ; elle construit une compréhension 3D sémantiquement riche de ce qui entoure le véhicule et des attributs de cet environnement.
Ce qui alimente les décisions du FSD
Ce modèle de monde 3D haute précision en temps réel — construit à partir des estimations d'occupation et de surface — alimente les étapes ultérieures de la pile : prédiction (ce que les autres usagers de la route sont susceptibles de faire), planification de trajectoire (l'itinéraire le plus sûr et le plus efficace) et contrôle (exécuter le plan en douceur). Vous pouvez en savoir plus sur la manière dont ces composants sont abordés dans la partie 1 de la série.
Le chemin vers la conduite entièrement autonome reste difficile, mais ces méthodes d'occupation et de surface sont des piliers fondamentaux pour un système qui ne se contente pas de détecter des modèles, mais qui perçoit et comprend les environnements dynamiques et complexes rencontrés par les véhicules.
















Partager:
Musk sème encore plus d'indices sur le nouveau SUV plus grand de Tesla
Le secret de Tesla pour le rayon de braquage incroyable du Cybertruck : les quatre roues directrices expliquées