

Le système FSD de Tesla a constamment suivi une approche fondamentale : naviguer et interagir avec le monde physique en utilisant uniquement la vision et une intelligence artificielle généralisée.
Les explications précédentes sur le fonctionnement du FSD ont décrit comment ses réseaux de neurones construisent des espaces tridimensionnels à partir de pixels bidimensionnels et suivent les objets en mouvement au fil du temps. Pourtant, l'un des problèmes les plus ardus en matière d'autonomie n'est pas lié aux obstacles dynamiques, mais à la logique implicite, changeante et centrée sur l'humain de la conception des routes.
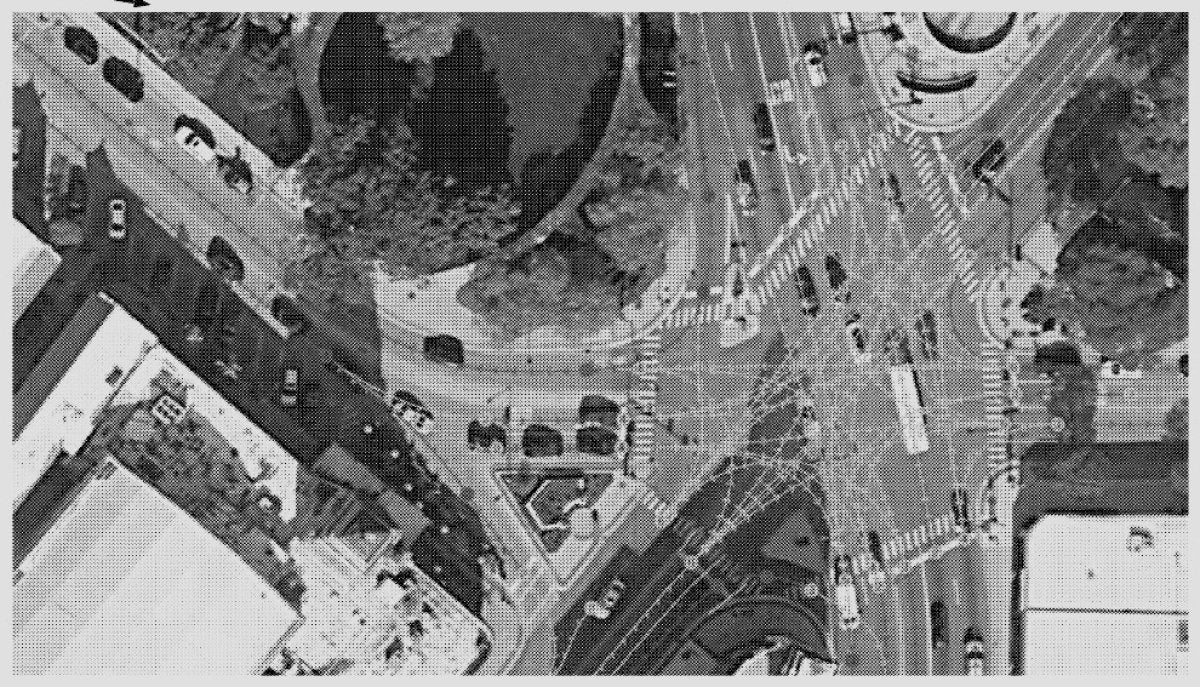
À une intersection complexe et non cartographiée comportant plusieurs voies, un véhicule autonome doit déduire quelle voie d'entrée se connecte à quel chemin de sortie. Des entreprises comme Waymo et Zoox abordent ce problème en s'appuyant sur des cartes localisées haute définition fragiles. Tesla traite cette tâche comme un problème d'inférence dynamique.
Une récente demande de brevet, US 2026/0170852 A1, intitulée « Vision-Based Machine Learning Model for Lane Connectivity in Autonomous or Semi-Autonomous Driving » (Modèle d'apprentissage automatique basé sur la vision pour la connectivité des voies dans la conduite autonome ou semi-autonome), présente une solution qui adapte une architecture courante dans l'IA générative et les grands modèles de langage (LLM) : le transformeur autorégressif.
Tokeniser l'asphalte
Les grands modèles de langage génèrent du texte « token » par « token » (jeton par jeton). Lorsqu'un système comme Grok produit du texte, il sélectionne le jeton suivant le plus probable en fonction des jetons déjà émis, plutôt que de produire un paragraphe complet en une seule étape.
Tesla applique une stratégie similaire à la géométrie routière. Pendant que la voiture roule, le système de vision alimente les réseaux de neurones du FSD avec des images brutes. Des réseaux dorsaux traitent les pixels, et un transformeur à attention croisée fusionne les vues de plusieurs caméras dans un espace vectoriel tridimensionnel vu du dessus, connu sous le nom de vue à vol d'oiseau (BEV).
Le flux de bout en bout est : [Pixels des caméras] ➔ [Réseaux dorsaux] ➔ [Fusion multicaméras] ➔ [Transformeurs autorégressifs] ➔ [Graphe de voies]
Une fois la représentation spatiale établie, le réseau commence à « lire » l'intersection. Il transforme les coordonnées en jetons afin que les positions physiques sur la route soient représentées sous forme de jetons discrets.
Les blocs autorégressifs choisissent ensuite une coordonnée initiale, telle que le point de départ d'une voie, et prédisent les points spatiaux successifs (coordonnées X, Y) le long du chemin carrossable.
La boucle autorégressive
Prédiction initiale : Le réseau identifie un jeton d'entrée à l'embouchure d'une intersection.
Alimentation contextuelle : Ce jeton est réinjecté dans les blocs autorégressifs avec les cartes de caractéristiques spatiales.
Suivi séquentiel : En utilisant le contexte accumulé, le modèle prédit le point plausible suivant dans la voie, enchaînant les jetons pour former un chemin précis à travers l'intersection.
Étiquetage des attributs structurels : En parallèle, le système assigne des attributs à chaque jeton de coordonnée, étiquetant si un point correspond à un chemin de circulation standard, un vecteur de fusion, une bifurcation, ou l'intérieur d'une intersection sans marquage au sol visible.
La boucle se répète de nombreuses fois — généralement entre 64 et 108 inférences par cycle. Lorsqu'une voie est entièrement tracée et terminée, le processus redémarre pour modéliser les voies voisines.
En exprimant les voies comme une séquence de jetons, le réseau écrit efficacement une « phrase » qui capture toute l'intersection. Même dans le cas d'une séparation à cinq voies imprévisible ou d'un virage serré, le transformeur utilise le contexte environnant pour maintenir une trajectoire cohérente afin que le véhicule ne change pas de voie au milieu de l'intersection.
Surmonter l'amnésie à travers le temps et l'espace
Le brevet note que les routes réelles présentent souvent des perturbations sensorielles : les marquages au sol peuvent être usés, obscurcis par des débris de chantier ou cachés derrière de gros véhicules de tête, tels que des camions commerciaux. Pour contrer l'amnésie spatiale immédiate, le système intègre un module de file d'attente vidéo dédié.
Cette file d'attente vidéo fournit une mémoire spatiale et temporelle à court terme. À mesure que le véhicule avance, les caractéristiques des horodatages précédents sont conservées. Une étape d'alignement des images les maintient cohérentes dans le temps ; par exemple, si la voiture se déplace de 20 mètres, les cartes de caractéristiques historiques dans la file d'attente sont décalées pour compenser l'ego-mouvement.
Grâce à cet alignement, si une ligne de voie disparaît sous un véhicule proche, les blocs autorégressifs peuvent se référer aux caractéristiques historiques pour continuer à prédire la connectivité de la voie sans interruption.
Les cartes sont un indice, pas la vérité
L'industrie a longtemps soutenu qu'une conduite autonome sécurisée nécessitait des cartes HD précises au centimètre près. Tesla Vision a déjà démontré une alternative généralisée, et ce brevet détaille comment cette approche peut fonctionner pour la connectivité des voies.
Les données cartographiques standard peuvent être fournies comme entrée auxiliaire, mais uniquement à titre d'indication. L'architecture peut injecter un signal « je ne sais pas » lorsque les données cartographiques localisées semblent peu fiables ou obsolètes pour une zone géographique donnée.
Donner la priorité à la vision en direct garantit que le système se comporte davantage comme un conducteur humain qualifié : il analyse la scène, interprète le contexte de l'intersection et déduit l'itinéraire correct par raisonnement visuel plutôt que de dépendre d'entrées cartographiques périmées.
Alors que Tesla progresse vers la commercialisation d'un réseau de transport de passagers sans conducteur, ces travaux indiquent que la pile logicielle ne se contente pas de traiter des images : elle lit activement le monde.
- Comment fonctionne le FSD, partie 1
- Comment fonctionne le FSD, partie 2
- Comment fonctionne le FSD, partie 3
- Comment fonctionne le FSD, partie 4
- Comment fonctionne le FSD, partie 5
- Comment fonctionne le FSD, partie 6 (cet article)
- Le réseau d'occupation de Tesla
- Le traducteur d'IA universel de Tesla
- Comment Tesla optimise le FSD
- Comment Tesla étiquettera les données avec l'IA


Partager:
La NHTSA clôt l'enquête sur les défaillances de direction des Tesla Model 3/Y
La vérité sur la mise à jour FSD v14 « Lite » de Tesla pour les propriétaires de matériel HW3