
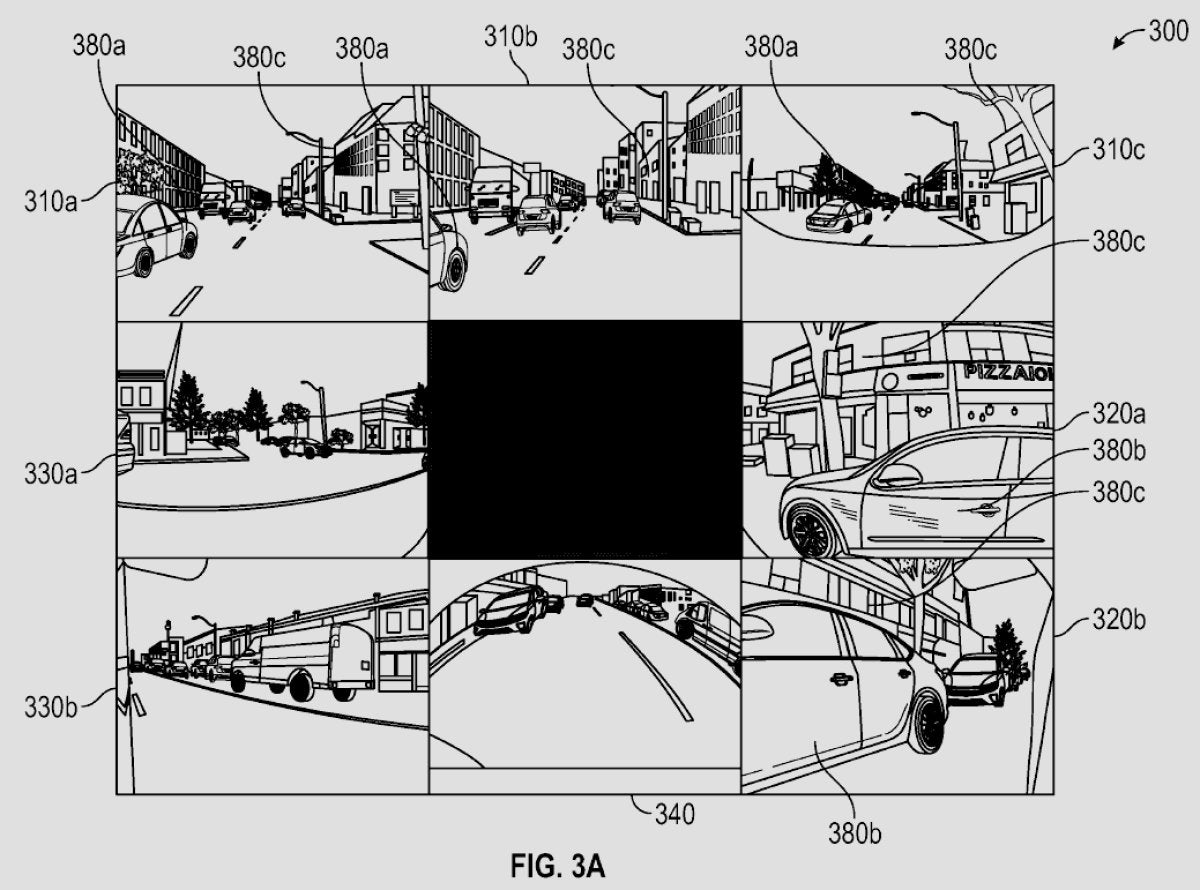
Las partes anteriores de esta serie cubrieron los fundamentos de la arquitectura de asistencia al conductor de la empresa y cómo interpreta las escenas. Esta entrega se centra en cómo el sistema convierte los fotogramas planos de las cámaras en la representación tridimensional que utiliza para conducir, basándose en dos solicitudes de patente: Determinación de ocupación basada en visión y Determinación de superficie basada en visión. Juntas, describen cómo la arquitectura percibe todo, desde vehículos hasta la textura de la carretera, utilizando únicamente la visión.
Cómo funciona FSD Parte 1
Cómo funciona FSD Parte 2
Cómo funciona FSD Parte 3 (este artículo)
El traductor de IA universal de Tesla
Cómo optimiza Tesla el FSD
Cómo etiquetará Tesla los datos con IA

Crear un mundo en 3D a partir de imágenes en 2D
El problema central de un sistema de asistencia al conductor basado en visión es reconstruir una escena tridimensional a partir de entradas de cámara bidimensionales. A diferencia de los enfoques que utilizan LiDAR para medir la distancia directamente, un método basado solo en visión debe inferir la profundidad, la forma, el movimiento y el contexto a partir de los píxeles, la iluminación y cómo se mueven los objetos a través de múltiples perspectivas de cámara. La combinación de estas señales produce el entorno 3D en el que opera el planificador.
Parte 1: Determinación de ocupación basada en visión

La patente titulada “Técnicas de modelado de inteligencia artificial para la determinación de ocupación basada en visión” describe cómo el sistema identifica los objetos alrededor del vehículo y el espacio que ocupan. Las iteraciones anteriores utilizaban cajas delimitadoras en 2D; las versiones más nuevas apuntan a una comprensión verdaderamente volumétrica.
Arquitectura FSD: de píxeles a objetos

La patente describe una arquitectura de IA de varias etapas:
Entrada de imagen: se ingieren imágenes de cámara sin procesar desde múltiples puntos de vista alrededor del automóvil en un momento dado.
Featurización de imagen: redes neuronales especializadas llamadas «Featurizers» extraen características visuales útiles de los píxeles, como patrones, texturas y bordes.
Transformación espacial: una red tipo Transformer con un mecanismo de atención espacial proyecta las características de cada cámara en un marco 3D común y las fusiona. Internamente, esto forma el espacio vectorial en el que opera el planificador de rutas.
Alineación temporal: el sistema fusiona las características 3D en momentos consecutivos para que se vuelvan espaciotemporales, capturando no solo un instante, sino el movimiento a lo largo del tiempo.
Desconvolución: la representación fusionada se desconvoluciona para producir predicciones por vóxel a través de una cuadrícula 3D.
Un vóxel es el análogo en 3D de un píxel: un cubo pequeño que representa un punto en el espacio. El entorno alrededor del automóvil se discretiza en una cuadrícula densa de vóxeles.
A partir de las salidas desconvolucionadas, la red predice señales clave como la ocupación (libre u ocupado) y, cuando está ocupado, un vector de velocidad. Al agregar a través de los vóxeles, el sistema forma una imagen detallada del espacio cercano y de lo que lo llena, ya sea una estructura estática o un usuario de la vía en movimiento.

El resultado
Los resultados se compilan en un mapa de ocupación que la planificación posterior puede consultar para decidir las siguientes acciones: verificar si ciertas regiones están despejadas, si un objeto en un vóxel se está moviendo, qué podría ser y si es importante para la conducción. El planificador utiliza este modelo 3D continuamente actualizado para tomar decisiones momento a momento, muy parecido a navegar en un mundo al estilo «videojuego» en vivo donde las entidades tienen ubicación, movimiento y tipo.
Parte 2: Determinación de superficie basada en visión
Detectar objetos es solo una parte del problema; comprender la superficie transitable y el terreno circundante es igualmente importante. La patente WO2024237939A2, “Técnicas de modelado de inteligencia artificial para la determinación de superficie basada en visión”, aborda esta necesidad.
Comprensión de la superficie
El sistema debe inferir mucho más que «hay una carretera». Estima la geometría de la carretera (plana, cuesta arriba, peraltada), el material de la superficie (asfalto, tierra, grava), bordillos, marcas de carril, topes de velocidad, baches y si una región es realmente navegable. La patente explica cómo alcanzar este nivel de detalle solo con cámaras, reduciendo la dependencia de mapas de alta definición preexistentes.
Para aquellos que observan de cerca, el sistema intenta identificar baches; si el planificador utiliza actualmente esa señal puede variar. En 2020, Elon confirmó que este era el caso.
¡Sí! Estamos etiquetando baches y hundimientos, para que el automóvil pueda reducir la velocidad o rodearlos cuando sea seguro hacerlo.
— Elon Musk (@elonmusk) 14 de agosto de 2020
La empresa también ha discutido el ajuste de las suspensiones neumáticas y adaptativas en función de un mapa de rugosidad de la carretera. Dichos mapas podrían combinar los resultados de la Determinación de superficie basada en visión con señales de los nuevos sensores inteligentes en la banda de rodadura de los neumáticos que ahora se instalan en ciertos vehículos insignia.
Predicción de atributos de superficie a partir de la visión
Este componente analiza las imágenes para predecir atributos de la superficie en lugar de la ocupación de objetos. Los resultados incluyen elevación, navegabilidad y seguridad para la conducción, material de la superficie y características como líneas de carril, marcas, bordillos, topes, baches, crestas de colinas y curvas peraltadas o planas.
Construcción de la malla de superficie 3D
Estas predicciones se ensamblan en una malla 3D del entorno derivada de imágenes 2D. La malla es un conjunto de puntos con coordenadas X, Y y Z, cada uno etiquetado con los atributos inferidos, formando parte del mundo 3D general que utiliza el sistema.

Entrenamiento para el reconocimiento de superficies
El entrenamiento aprovecha fuentes de profundidad de alta fidelidad, como LIDAR durante las pruebas y la generación de datos, así como la fotogrametría. Estos se alinean con las imágenes de cámara capturadas por vehículos reales para aprender distancias y propiedades de la superficie.
Ocupación + Superficies = Modelo mundial unificado
Los sistemas de ocupación y superficie están diseñados para trabajar juntos. Por ejemplo, si la ocupación detecta un cono de tráfico mientras el sistema de superficie reconoce una colina empinada más adelante, el modelo puede colocar el cono con precisión en la pendiente de la colina dentro del mundo 3D. Separar la detección de objetos de la comprensión de la superficie mejora la robustez en entornos con elevación variable y aumenta el rango vertical en el que los objetos pueden localizarse de manera confiable.
Como resultado, la arquitectura no solo percibe objetos aislados y un plano de suelo plano; construye una comprensión 3D semánticamente rica de lo que hay alrededor del vehículo y los atributos de ese entorno.
Qué impulsa las decisiones del FSD
Este modelo mundial 3D en tiempo real y de gran detalle, construido a partir de estimaciones de ocupación y superficie, alimenta las etapas posteriores de la arquitectura: predicción (qué es probable que hagan otros usuarios de la vía), planificación de rutas (la ruta más segura y eficiente) y control (ejecutar el plan sin problemas). Puede leer más sobre cómo se abordan esos componentes en la Parte 1 de la serie.
El camino hacia la conducción autónoma total sigue siendo un desafío, pero estos métodos de ocupación y superficie son bloques de construcción fundamentales para un sistema que no solo detecta patrones, sino que también percibe y comprende los entornos dinámicos y complejos que encuentran los vehículos.
















Compartir:
Musk lanza aún más pistas sobre el nuevo SUV más grande de Tesla
El secreto de Tesla para el increíble radio de giro del Cybertruck: la dirección en las cuatro ruedas explicada