
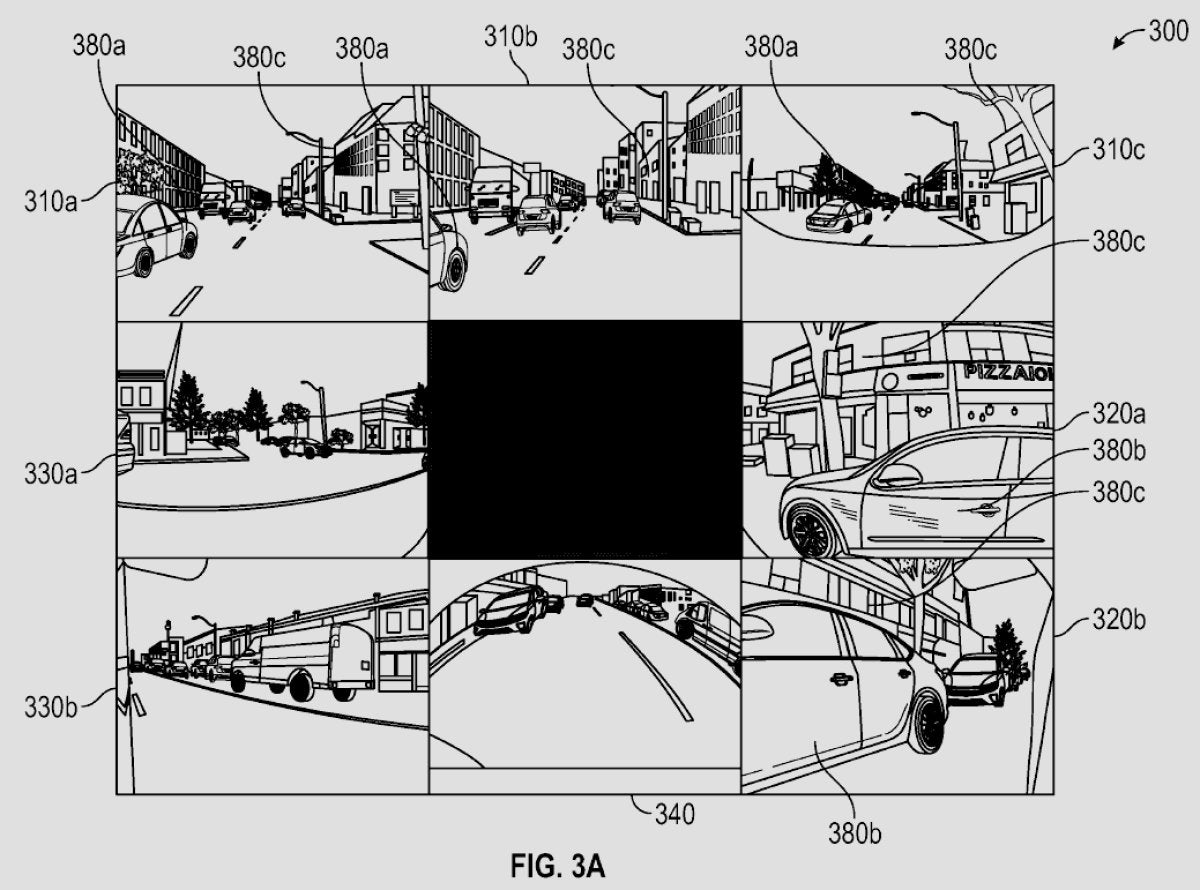
Frühere Teile dieser Serie befassten sich mit den Grundlagen des Fahrerassistenz-Stacks des Unternehmens und wie dieser Szenen interpretiert. Diese Ausgabe konzentriert sich darauf, wie das System flache Kamerabilder in die dreidimensionale Repräsentation umwandelt, die es für das Fahren nutzt. Dabei stützt sie sich auf zwei Patentanmeldungen: Vision-Based Occupancy Determination (visueller Belegungsnachweis) und Vision-Based Surface Determination (visuelle Oberflächenbestimmung). Zusammen beschreiben sie, wie der Stack alles von Fahrzeugen bis zur Straßenbeschaffenheit allein durch visuelle Wahrnehmung erfasst.
Wie FSD funktioniert Teil 1
Wie FSD funktioniert Teil 2
Wie FSD funktioniert Teil 3 (dieser Artikel)
Teslas universeller KI-Übersetzer
Wie Tesla FSD optimiert
Wie Tesla Daten mit KI kennzeichnen wird

Erstellung einer 3D-Welt aus 2D-Bildern
Das Kernproblem eines kamerabasierten Fahrerassistenzsystems ist die Rekonstruktion einer dreidimensionalen Szene aus zweidimensionalen Kameraeingaben. Im Gegensatz zu Ansätzen, die LiDAR zur direkten Distanzmessung verwenden, muss eine reine Vision-Methode Tiefe, Form, Bewegung und Kontext aus Pixeln, Beleuchtung und der Art und Weise ableiten, wie sich Objekte über mehrere Kameraperspektiven hinweg bewegen. Die Kombination dieser Hinweise ergibt die 3D-Umgebung, in der der Planer agiert.
Teil 1: Vision-Based Occupancy Determination

Das Patent mit dem Titel „Artificial Intelligence Modeling Techniques for Vision-Based Occupancy Determination“ beschreibt, wie das System Objekte in der Umgebung des Fahrzeugs und den Raum, den sie einnehmen, identifiziert. Frühere Iterationen verwendeten 2D-Begrenzungsrahmen; neuere Versionen zielen auf ein echtes volumetrisches Verständnis ab.
FSD-Pipeline: Von Pixeln zu Objekten

Das Patent skizziert eine mehrstufige KI-Pipeline:
Bildeingabe: Rohkamerabilder aus mehreren Blickwinkeln rund um das Auto werden zu einem bestimmten Zeitpunkt eingelesen.
Bild-Featurisierung: Spezialisierte neuronale Netze, sogenannte „Featurizer“, extrahieren nützliche visuelle Merkmale aus den Pixeln, wie etwa Muster, Texturen und Kanten.
Räumliche Transformation: Ein Transformer-Netzwerk mit einem räumlichen Aufmerksamkeitsmechanismus projiziert die Merkmale jeder Kamera in einen gemeinsamen 3D-Rahmen und führt sie zusammen. Intern bildet dies den Vektorraum, in dem der Pfadplaner arbeitet.
Zeitliche Ausrichtung: Das System führt 3D-Merkmale über aufeinanderfolgende Zeitpunkte hinweg zusammen, sodass sie raumzeitlich werden und nicht nur einen Moment, sondern die Bewegung über die Zeit erfassen.
Dekonvolution: Die zusammengeführte Repräsentation wird dekonvolviert, um Voxel-basierte Vorhersagen über ein 3D-Gitter zu erzeugen.
Ein Voxel ist das 3D-Analogon zu einem Pixel: ein winziger Würfel, der einen Punkt im Raum repräsentiert. Die Umgebung um das Auto herum wird in ein dichtes Gitter aus Voxeln diskretisiert.
Aus den dekonvolvierten Ausgaben sagt das Netzwerk Schlüsselsignale wie die Belegung (frei oder belegt) und, falls belegt, einen Geschwindigkeitsvektor voraus. Durch die Aggregation über Voxel bildet das System ein detailliertes Bild des nahen Raums und dessen Inhalts—sei es eine statische Struktur oder ein sich bewegender Verkehrsteilnehmer.

Die Ausgabe
Die Ergebnisse werden in einer Belegungskarte zusammengefasst, die die nachgelagerte Planung abfragen kann, um nächste Schritte zu entscheiden – etwa die Prüfung, ob bestimmte Bereiche frei sind, ob sich ein Objekt in einem Voxel bewegt, was es sein könnte und ob es für das Fahren relevant ist. Der Planer nutzt dieses kontinuierlich aktualisierte 3D-Modell, um von Moment zu Moment Entscheidungen zu treffen, ähnlich wie bei der Navigation in einer Welt im „Videospiel“-Stil, in der Einheiten Position, Bewegung und Typ besitzen.
Teil 2: Vision-Based Surface Determination
Das Erkennen von Objekten ist nur ein Teil des Problems; das Verständnis der befahrbaren Oberfläche und des umliegenden Geländes ist ebenso wichtig. Das Patent WO2024237939A2, „Artificial Intelligence Modeling Techniques for Vision-Based Surface Determination“, adressiert diesen Bedarf.
Oberflächenverständnis
Das System muss weit mehr ableiten können als nur „da ist eine Straße“. Es schätzt Straßengeometrie (flach, bergauf, geneigt), Oberflächenmaterial (Asphalt, Erde, Schotter), Bordsteine, Fahrbahnmarkierungen, Bremsschwellen, Schlaglöcher und ob ein Bereich tatsächlich befahrbar ist. Das Patent erklärt, wie man diesen Detailgrad allein durch Kameras erreicht und so die Abhängigkeit von bereits vorhandenen hochauflösenden Karten reduziert.
Für aufmerksame Beobachter: Das System versucht tatsächlich, Schlaglöcher zu identifizieren; ob der Planer dieses Signal aktuell verwendet, kann variieren. Bereits 2020 bestätigte Elon, dass dies der Fall ist.
Ja! Wir kennzeichnen Bodenwellen & Schlaglöcher, damit das Auto langsamer werden oder sicher darum herumlenken kann.
— Elon Musk (@elonmusk) 14. August 2020
Das Unternehmen hat auch darüber gesprochen, die Luft- und adaptiven Federungen basierend auf einer Karte der Straßenbeschaffenheit anzupassen. Solche Karten könnten die Ausgaben der Vision-Based Surface Determination mit Signalen neuer intelligenter Reifensensoren kombinieren, die derzeit in bestimmten Flaggschiff-Fahrzeugen verbaut werden.
Vorhersage von Oberflächenattributen aus der Sicht
Diese Komponente analysiert Bilder, um Oberflächenattribute anstelle von Objektbelegungen vorherzusagen. Die Ausgaben umfassen Höhe, Befahrbarkeit und Sicherheit, Oberflächenmaterial sowie Merkmale wie Fahrbahnlinien, Markierungen, Bordsteine, Bremsschwellen, Schlaglöcher, Hügelkuppen sowie geneigte oder flache Kurven.
Erstellung des 3D-Oberflächennetzes
Diese Vorhersagen werden in einem 3D-Netz der Umgebung zusammengesetzt, das aus 2D-Bildern abgeleitet wurde. Das Netz ist eine Menge von Punkten mit X-, Y- und Z-Koordinaten, die jeweils mit den abgeleiteten Attributen versehen sind und einen Teil der gesamten 3D-Welt bilden, die das System verwendet.

Training für die Oberflächenerkennung
Das Training nutzt hochauflösende Tiefenquellen wie LIDAR während der Test- und Datengenerierungsphase sowie Photogrammetrie. Diese werden mit Kamerabildern abgeglichen, die von echten Fahrzeugen aufgenommen wurden, um Distanzen und Oberflächeneigenschaften zu erlernen.
Belegung + Oberflächen = Einheitliches Weltmodell
Die Belegungs- und Oberflächensysteme sind so konzipiert, dass sie zusammenarbeiten. Wenn die Belegungserkennung beispielsweise einen Verkehrskegel entdeckt, während das Oberflächensystem einen steilen Hügel voraus erkennt, kann das Modell den Kegel präzise auf dem Hang des Hügels innerhalb der 3D-Welt platzieren. Die Trennung von Objekterkennung und Oberflächenverständnis verbessert die Robustheit in Umgebungen mit unterschiedlichen Höhen und erhöht den vertikalen Bereich, in dem Objekte zuverlässig lokalisiert werden können.
Das Ergebnis ist, dass der Stack nicht nur isolierte Objekte und eine flache Bodenebene wahrnimmt; er baut ein semantisch reiches 3D-Verständnis dessen auf, was sich um das Fahrzeug herum befindet und welche Attribute diese Umgebung besitzt.
Was FSD-Entscheidungen antreibt
Dieses hochdetaillierte Echtzeit-3D-Weltmodell—aufgebaut aus Belegungs- und Oberflächenschätzungen—speist die nachfolgenden Stufen des Stacks: Vorhersage (was andere Verkehrsteilnehmer wahrscheinlich tun werden), Pfadplanung (die sicherste und effizienteste Route) und Kontrolle (die reibungslose Ausführung des Plans). Mehr darüber, wie diese Komponenten adressiert werden, können Sie in Teil 1 der Serie lesen.
Der Weg zum vollständig autonomen Fahren bleibt eine Herausforderung, aber diese Methoden zur Belegungs- und Oberflächenbestimmung sind grundlegende Bausteine für ein System, das nicht nur Muster erkennt, sondern auch die dynamischen, komplexen Umgebungen wahrnimmt und versteht, denen Fahrzeuge begegnen.
















Teilen:
Musk gibt weitere Hinweise auf Teslas neues, größeres SUV
Teslas Geheimnis für den irren Wendekreis des Cybertrucks: Allradlenkung erklärt