
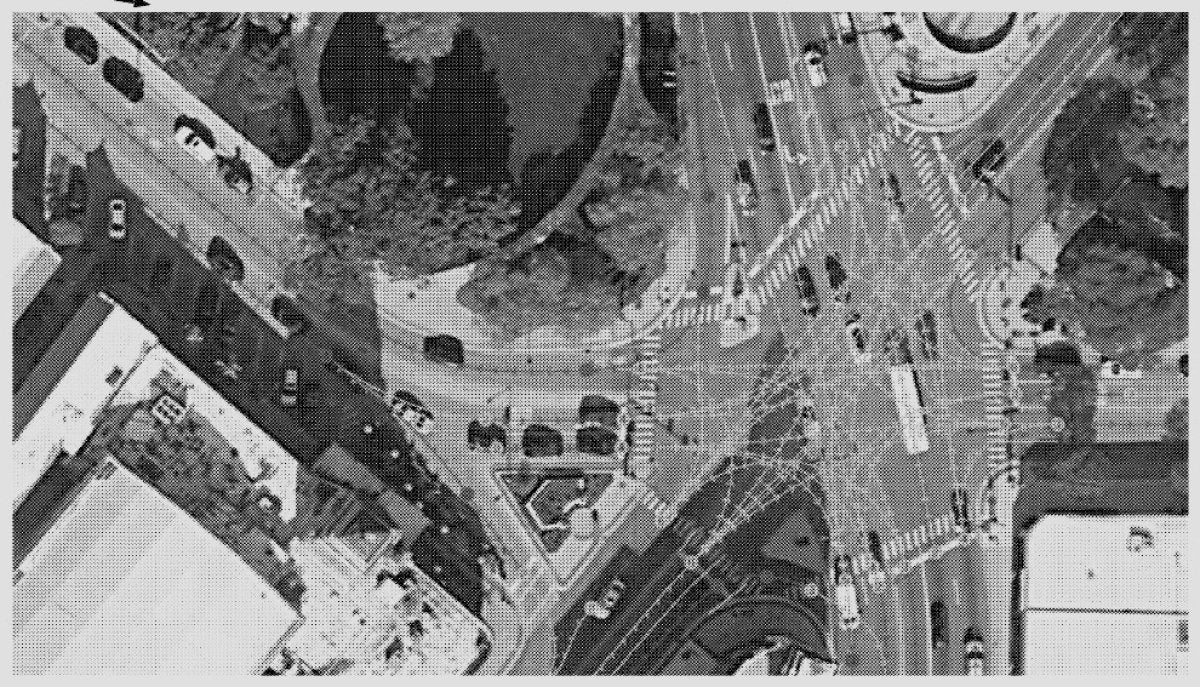

Teslas FSD verfolgt konsequent einen grundlegenden Ansatz: Die Navigation und Interaktion mit der physischen Welt erfolgt ausschließlich über vision-basierte Sensorik und verallgemeinerte künstliche Intelligenz.
Frühere Erläuterungen zur Funktionsweise von FSD beschrieben, wie die neuronalen Netze dreidimensionale Räume aus zweidimensionalen Pixeln konstruieren und sich bewegende Objekte über die Zeit hinweg verfolgen. Doch eines der schwierigsten Probleme beim autonomen Fahren sind nicht dynamische Hindernisse, sondern die implizite, sich wandelnde und auf den Menschen ausgerichtete Logik der Straßengestaltung.
An einer nicht kartierten, komplexen Kreuzung mit mehreren Spuren muss ein autonomes Fahrzeug ableiten, welche Zufahrtsspur mit welchem weiterführenden Pfad verbunden ist. Unternehmen wie Waymo und Zoox lösen dies durch die Abhängigkeit von anfälligen, hochauflösenden lokalisierten Karten. Tesla geht diese Aufgabe als ein Problem der dynamischen Schlussfolgerung an.
Eine aktuelle Patentanmeldung, US 2026/0170852 A1 mit dem Titel „Vision-Based Machine Learning Model for Lane Connectivity in Autonomous or Semi-Autonomous Driving“, skizziert eine Lösung, die eine in der generativen KI und bei Sprachmodellen (LLMs) verbreitete Architektur adaptiert: den autoregressiven Transformer.
Tokenisierung von Asphalt
Große Sprachmodelle generieren Text Token für Token. Wenn ein System wie Grok Text erzeugt, wählt es auf Basis der bereits ausgegebenen Token das wahrscheinlichste nächste Token aus, anstatt einen vollständigen Absatz in einem Schritt zu produzieren.
Tesla wendet eine ähnliche Strategie auf die Straßengeometrie an. Während das Auto fährt, speist das Kamerasystem Rohbilder in die neuronalen Netze von FSD ein. Backbone-Netzwerke verarbeiten die Pixel, und ein Cross-Attention-Transformer führt mehrere Kameraansichten zu einem dreidimensionalen Vektorraum aus der Vogelperspektive (Bird’s-Eye View, BEV) zusammen.
Der End-to-End-Ablauf lautet: [Kamerapixel] ➔ [Backbone-Netzwerke] ➔ [Multicam-Fusion] ➔ [Autoregressive Transformer] ➔ [Spurgraph]
Sobald die räumliche Repräsentation etabliert ist, beginnt das Netzwerk, die Kreuzung zu „lesen“. Es tokenisiert Koordinaten, sodass physische Straßenpositionen als diskrete Token dargestellt werden.
Autoregressive Blöcke wählen dann eine Startkoordinate aus, etwa den Anfangspunkt einer Spur, und sagen aufeinanderfolgende räumliche Punkte (X-, Y-Koordinaten) entlang des befahrbaren Pfades voraus.
Die autoregressive Schleife
Erste Vorhersage: Das Netzwerk identifiziert ein Eingangs-Token am Anfang einer Kreuzung.
Kontextuelle Einspeisung: Dieses Token wird zusammen mit räumlichen Merkmalskarten in die autoregressiven Blöcke zurückgeführt.
Sequenzielle Verfolgung: Unter Verwendung des akkumulierten Kontexts sagt das Modell den nächsten plausiblen Punkt in der Spur voraus und verkettet die Token zu einem präzisen Pfad durch die Kreuzung.
Zuweisung struktureller Attribute: Parallel dazu weist das System jedem Koordinaten-Token Attribute zu und kennzeichnet, ob ein Punkt einem Standardfahrweg, einem Einfädelungsvektor, einer Abzweigung oder dem Kreuzungsinneren ohne sichtbare Fahrbahnmarkierungen entspricht.
Die Schleife wiederholt sich viele Male – typischerweise zwischen 64 und 108 Schlussfolgerungen pro Zyklus. Wenn eine Spur vollständig nachgezeichnet und beendet ist, beginnt der Prozess von neuem, um benachbarte Spuren zu modellieren.
Indem Spuren als eine Folge von Token ausgedrückt werden, schreibt das Netzwerk effektiv einen „Satz“, der die gesamte Kreuzung erfasst. Selbst bei einer unvorhersehbaren Fünf-Wege-Kreuzung oder einer scharfen Kurve nutzt der Transformer den umliegenden Kontext, um eine konsistente Trajektorie beizubehalten, damit das Fahrzeug nicht mitten auf der Kreuzung den Pfad wechselt.
Überwindung von Amnesie über Zeit und Raum
Das Patent merkt an, dass reale Straßen oft sensorische Störungen aufweisen: Fahrbahnmarkierungen können abgenutzt, durch Bauschutt verdeckt oder hinter großen vorausfahrenden Fahrzeugen wie Lieferwagen verborgen sein. Um der unmittelbaren räumlichen Amnesie entgegenzuwirken, integriert das System ein dediziertes Video-Warteschlangenmodul.
Diese Video-Warteschlange bietet ein kurzfristiges räumliches und zeitliches Gedächtnis. Während sich das Fahrzeug vorwärts bewegt, werden Merkmale aus früheren Zeitstempeln beibehalten. Ein Frame-Ausrichtungsschritt hält diese über die Zeit konsistent; wenn sich das Auto beispielsweise 20 Meter bewegt, werden die historischen Merkmalskarten in der Warteschlange verschoben, um die Eigenbewegung auszugleichen.
Mit dieser Ausrichtung können die autoregressiven Blöcke auf historische Merkmale zurückgreifen, falls eine Spurmarkierung unter einem nahen Fahrzeug verschwindet, um die Spurenvernetzung ohne Unterbrechung weiter vorherzusagen.
Karten sind ein Hinweis, keine absolute Wahrheit
Die Industrie argumentiert seit langem, dass ein sicherer fahrerloser Betrieb zentimetergenaue HD-Karten erfordert. Tesla Vision hat bereits eine verallgemeinerte Alternative demonstriert, und dieses Patent beschreibt, wie dieser Ansatz für die Spurenvernetzung funktionieren kann.
Standard-Kartendaten können als zusätzliche Eingabe bereitgestellt werden, jedoch nur als Hinweis. Die Architektur kann ein „Unbekannt“-Signal injizieren, wenn lokalisierte Kartendaten für ein bestimmtes geografisches Gebiet als unzuverlässig oder veraltet erscheinen.
Die Priorisierung der Live-Vision stellt sicher, dass sich das System eher wie ein erfahrener Mensch verhält: Es betrachtet die Szene, interpretiert den Kreuzungskontext und leitet die richtige Route durch visuelles Denken ab, anstatt sich auf veraltete Karteneinträge zu verlassen.
Auf dem Weg von Tesla zur Kommerzialisierung eines unüberwachten Ride-Hailing-Netzwerks zeigt diese Arbeit, dass der Stack nicht bloß Bilder verarbeitet, sondern die Welt aktiv liest.
- Wie FSD funktioniert Teil 1
- Wie FSD funktioniert Teil 2
- Wie FSD funktioniert Teil 3
- Wie FSD funktioniert Teil 4
- Wie FSD funktioniert Teil 5
- Wie FSD funktioniert Teil 6 (dieser Artikel)
- Teslas Occupancy Network
- Teslas universeller KI-Übersetzer
- Wie Tesla FSD optimiert
- Wie Tesla Daten mit KI kennzeichnen wird


Teilen:
NHTSA beendet Untersuchung zu Lenkungsproblemen bei Tesla Model 3/Y
Die Wahrheit über das „Lite“-Update von Teslas FSD v14 für HW3-Besitzer